Duże modele językowe na Twoim Macu.
LLaMer to aplikacja z ikoną w pasku menu, która uruchamia modele językowe lokalnie i udostępnia je programom tak samo jak LM Studio. Dzięki AirLLM odpalisz nawet modele większe niż RAM – bez kwantyzacji, bez opłat i bez wysyłania danych gdziekolwiek.
 2× 888 tok · 6.8 t/s
▞ ⟠ ◔ 6:54
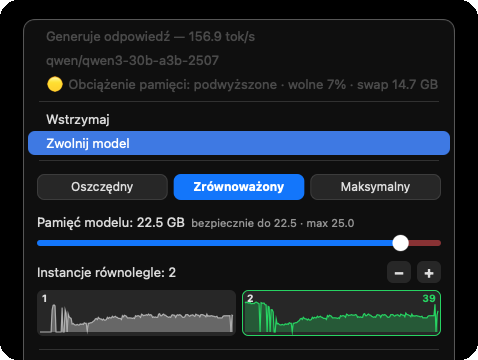
Panel sterowania prosto z paska menu
Lokalne modele kończą się na jednym zdaniu: brak pamięci.
Nowoczesne modele są ogromne. Nawet „mały" model 7B potrzebuje pamięci na wagi, na pamięć rozmowy i na wyniki pośrednie. Zwykle kończy się to jednym z trzech scenariuszy:
„Out of memory"
Model w ogóle się nie uruchamia – zabrakło pamięci, zanim zdążył policzyć pierwszy token.
Kwantyzacja
„Odchudzasz" model, żeby się zmieścił – kosztem jakości odpowiedzi, których już nie odzyskasz.
Droższy sprzęt lub chmura
Albo rachunki za API i limity zapytań, albo zakup mocniejszej maszyny.
Jak to działa
„Pamięć wirtualna" dla modelu
Model składa się z warstw liczonych jedna po drugiej – nie trzeba trzymać wszystkich naraz w pamięci. AirLLM wczytuje warstwę, liczy, zwalnia ją i przechodzi do następnej. Sam model się nie zmienia: nie jest przycinany ani przetrenowywany.
Pobierz model
W panelu masz przeglądarkę HuggingFace z filtrami. Jedno kliknięcie pobiera model do wybranego folderu – tego samego, z którego korzysta LM Studio.
Kliknij „Użyj"
LLaMer ładuje model: warstwy mieszczące się w budżecie pamięci zostają w RAM, reszta jest czytana z dysku z wyprzedzeniem. Budżet zmienisz w locie, bez przeładowania.
Podłącz narzędzia
Serwer słucha na localhost:1234 pod adresami /v1/… – tak jak LM Studio. Co potrafi połączyć się z LM Studio lub OpenAI, połączy się i z LLaMerem.
Wagi nie są kompresowane do niższej precyzji – dostajesz to, co model potrafi w oryginale. Ogranicza Cię miejsce na dysku, nie pamięć.
Możliwości
Wszystko, czego potrzebujesz do lokalnych modeli
Jedna aplikacja zamiast konsoli deweloperskiej: uruchamia, pokazuje i udostępnia modele – a Ty masz je pod kontrolą z paska menu.
Zamiennik LM Studio
To samo API (port 1234, adresy /v1/…). Wystarczy skierować narzędzia na adres LLaMera.
Modele większe niż RAM
AirLLM strumieniuje warstwy z dysku, więc odpalisz model, który normalnie by się nie zmieścił.
Pełna jakość
Bez kwantyzacji. Wagi w oryginalnej precyzji – płacisz czasem, nie jakością.
Prywatność i brak opłat
Rozmowy, dokumenty i prompty zostają na Twoim komputerze. Bez rachunków za API i limitów.
Suwak pamięci + instancje
Ustawiasz budżet GPU (ze strefą ryzyka) i liczbę równoległych instancji 1–16. Zmiana w locie.
Przeglądarka HuggingFace
Szukasz, filtrujesz (popularność, rozmiar, architektura) i pobierasz modele jednym kliknięciem.
Statystyki i dziennik
Wykres t/s z historią (rok, kwartał, miesiąc, dzień) i podgląd pracy serwera jak „Developer Logs".
Wartownik pamięci
Przy krytycznym obciążeniu pamięci macOS LLaMer sam wstrzymuje pracę, a po powrocie do normy wznawia.
Kontrola z paska menu
Przy ikonie lamy od razu widzisz stan: LOADING, IDLE, bieżące tokeny i prędkość, ile zapytań pracuje, a ile czeka. Jedno kliknięcie wstrzymuje liczenie, gdy Mac jest potrzebny do czego innego – a ręczna pauza przetrwa nawet restart aplikacji.
W akcji
Widzisz, co się dzieje – a nie surowe logi
Czy model odpoczywa, czy pisze, kto pyta, jak szybko i ile zajmuje pamięci. Wszystko w jednym panelu, po polsku.
- ✓Trzy tryby obok siebie: Oszczędny, Zrównoważony, Maksymalny (noc).
- ✓Suwak pamięci modelu od zera do limitu GPU – ze strefą ryzyka na czerwono.
- ✓Kafelki instancji z wykresem prędkości z ostatniej godziny – kolor wg obciążenia pamięci.
- ✓Natychmiastowa pauza i podgląd tokenów na sekundę wprost z menu.
To nie makieta – tak wygląda menu LLaMera
IDLEModel załadowany, nic się nie dzieje.888 tok · 25.0 t/sGenerowanie: liczba tokenów i prędkość.2× 888 tok · 6.8 t/sKilka zapytań pracuje naraz – prędkości się sumują.2× +2 czeka · 50.0 t/sCzęść zapytań czeka na wolną instancję.PAUSED 888 tokPauza, z liczbą tokenów wstrzymanej odpowiedzi.Instrukcja
Instancje równoległe – ile zapytań naraz
W LLaMerze „instancje równoległe" to równoległe sloty na jednym załadowanym modelu – jeden proces liczy kilka zapytań naraz, to nie są osobne kopie modelu. Domyślnie są 2, więc model od razu, bez żadnych ustawień, obsłuży dwa równoczesne zapytania.
Co to jest
Slot = jedno zapytanie liczone w danym momencie. Domyślnie są 2 sloty, więc nie trzeba uruchamiać drugiej instancji – wystarczą 2 zapytania naraz. Zakres 1–16; każdy slot ma swój kafelek z wykresem prędkości z ostatniej godziny.
Jak używać
Liczbę zmieniasz przyciskami − i + w panelu – albo wybierasz tryb: Oszczędny (mało), Zrównoważony lub Maksymalny (noc) (dużo). Zmiana działa w locie, bez gubienia zapytań.
Jakie daje efekty
Więcej slotów = większa łączna przepustowość i krótsza kolejka (kilka aplikacji albo agentów naraz). Ale wszystkie dzielą pamięć i moc jednego modelu: za dużo wchodzi w strefę ryzyka, a pojedyncza odpowiedź zwalnia.
Gdy zapytań jest więcej niż slotów, nadmiar czeka w kolejce – w menu widać to jako +2 czeka. W praktyce: domyślne 2 sloty wystarczają do pracy w pojedynkę i lekkiej równoległości; więcej gdy obsługujesz wielu klientów naraz – pipeline RAG, agentów albo cały zespół.
Silniki i formaty
Dwa silniki pod spodem
LLaMer czyta ten sam katalog modeli co LM Studio i używa tych samych nazw. Dobiera silnik do formatu.
| Format | Silnik | Do czego | Stan |
|---|---|---|---|
| GGUF | llama.cpp (Metal) | Szybka, codzienna praca; pauza natychmiastowa. | działa |
| Llama safetensors | AirLLM + własna pętla | Modele większe niż RAM, gdy liczy się jakość. | działa |
| MLX | — | — | wkrótce |
Cena tego podejścia: szybkość
Gramy w otwarte karty – AirLLM ma wyraźny koszt i warto go znać przed startem:
- Mniejsza przepustowość. Czytanie wag z dysku przy każdym tokenie jest wolniejsze niż model w całości w pamięci. Przy dużych modelach spodziewaj się odpowiedzi liczonych w minutach, nie sekundach.
- Dysk ma znaczenie. Szybki SSD robi ogromną różnicę; wolny dysk spowalnia wszystko.
- Nie dla dużego ruchu. To narzędzie do pracy osobistej i eksperymentów, nie do tysięcy zapytań.
- Pierwsze uruchomienie trwa dłużej. Model jest raz dzielony na warstwy i zapisywany na dysku.
Dla programistów
Drop-in zamiennik, bez zmian w kodzie
Pola zgodne z LM Studio (id, state, arch…) zostają bez zmian, żeby narzędzia łączyły się jak dotąd. Serwer przedstawia się dodatkowo – łatwo poznasz, że to LLaMer.
- Nagłówek
Server: LLaMer/…iX-Served-By: PTODT LLaMerw każdej odpowiedzi. /v1/models→owned_by: "llamer";system_fingerprintw odpowiedziach czatu.- Rozszerzone API: ładowanie i zwalnianie modelu bez restartu –
POST /v1/models/loadi/v1/models/unload(zarządzanie modelami jak w LM Studio). - Działa też z innych komputerów w Twojej sieci – po adresie IP Maca.
# ten sam adres i format co LM Studio
$ curl http://localhost:1234/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
      "model": "qwen/qwen3-30b-a3b-2507",
      "messages": [{"role":"user","content":"Cześć!"}]
    }'

# sprawdź, kto odpowiada
$ curl -sI localhost:1234/v1/models | grep -i server
Server: LLaMer/0.1.0 (build 7, d7c1b78)
Dla kogo
Gdy barierą jest pamięć, a jakość jest ważniejsza niż prędkość
Lokalne LLM-y na Macu
Chcesz uruchamiać duże modele u siebie, a główną barierą jest brak pamięci.
Programiści i badacze
Testujesz prompty, budujesz pipeline'y RAG i agentów na sprzęcie, który już masz.
Ceniący prywatność
Dane mają zostać na Twoim komputerze – bez chmury, rachunków i limitów.
Kiedy LLaMer nie jest dla Ciebie: gdy potrzebujesz odpowiedzi w czasie rzeczywistym albo obsługi dużego ruchu – wtedy wybierz mniejszy model uruchamiany w całości w pamięci.
Twój Mac potrafi więcej, niż myślisz.
LLaMer zamienia prostą ideę – „licz warstwa po warstwie" – w aplikację, która stawia duże modele pod Twoją kontrolą, lokalnie i prywatnie.
Napisz do nasLLaMer 0.1.0 · projekt PTODT · macOS na Apple Silicon · licencja MIT
FAQ
Krótkie odpowiedzi
Czym LLaMer różni się od LM Studio?
/v1/…) i czyta ten sam katalog modeli, więc narzędzia łączą się bez zmian. Do tego dokłada AirLLM (modele większe niż RAM), panel i dziennik po polsku oraz sterowanie wprost z paska menu.Czy naprawdę uruchomię model większy niż RAM?
Jakie formaty modeli obsługuje?
Czy moje dane są prywatne?
Czy podłączę się z innego komputera?
Czy LLaMera można już pobrać?
Autor
Kto za tym stoi